Un PDF técnico parece un dato porque permite buscar, copiar y pegar. Pero cuando intentás alimentar con él un catálogo, un comparador, un presupuesto o una API, aparece el problema: el archivo conserva una representación visual, no necesariamente una estructura con significado.
Una tabla puede mezclar variantes, unidades, notas al pie y condiciones en una misma página. Un número puede ser un precio unitario, una potencia máxima, una dimensión nominal o una cantidad medida. Si se extrae sin contexto, el resultado parece preciso y puede estar equivocado.
Por eso el recorrido realista no es PDF → BC3. Es:
PDF → evidencia estructurada → revisión humana → exportación BC3 → validación y reimportación
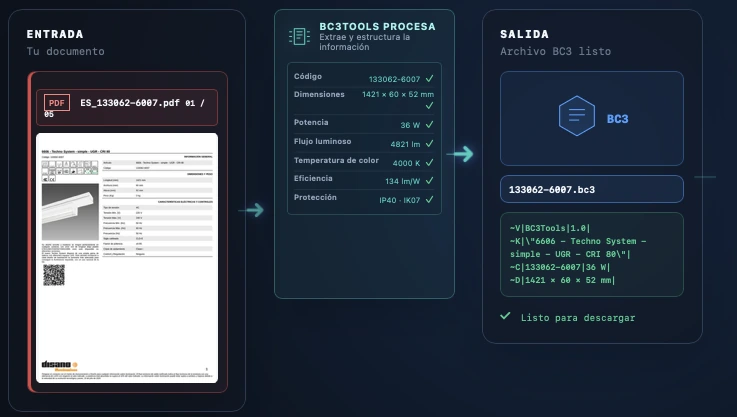
El diagrama resume el recorrido completo: el PDF es la entrada, la evidencia estructurada conserva los campos revisables, una persona controla el significado y la salida es un archivo BC3. Los valores que aparecen en la ilustración son un ejemplo visual, no una prestación universal; el recorte de BC3 no sustituye la especificación FIEBDC-3/2024, el comprobador oficial ni la comparación con el documento original.
La automatización acelera pasos repetitivos. No decide por sí sola qué declara el documento ni qué puede inferirse legítimamente de él.
El PDF es un documento; el BC3 es un intercambio de datos
Conviene separar cinco capas:
- Archivo: el PDF original, con nombre, hash, fecha y versión.
- Evidencia: texto, imagen, tabla, posición y página recuperados del documento.
- Dato: un atributo con valor, unidad, alcance y significado.
- Estructura: relaciones entre conceptos, descomposiciones, mediciones y precios.
- Uso: catálogo, presupuesto, aplicación de mediciones, API o herramienta interna.
El PDF puede ser excelente para leer, archivar o enviar una ficha. El problema aparece cuando se le exige actuar como una base de datos sin construir las capas intermedias.
FIEBDC-3/2024, conocido habitualmente como BC3, define un intercambio para bases de precios, presupuestos, mediciones y certificaciones. No es un formato genérico para “volcar cualquier texto”: exige representar conceptos y relaciones con una sintaxis, unos campos y unas reglas concretas.
La asociación FIEBDC publica el formato FIEBDC-3/2024, sus versiones vigentes y un comprobador BC3. La edición 2024 entró en vigor el 1 de enero de 2024. La compatibilidad de un programa no se deduce del nombre “BC3”: FIEBDC publica, por ejemplo, que Presto soporta FIEBDC-3/2024 a partir de Presto 2026.
Antes de extraer: inventariá el documento
El primer paso no es elegir una librería. Es saber qué documentos tenés:
- identificador del producto, familia y variante;
- fabricante o fuente responsable;
- idioma, fecha y número de revisión;
- PDF vigente y documentos que reemplaza;
- páginas que contienen especificaciones, tarifas o mediciones;
- permisos para procesar, almacenar y redistribuir la información;
- tipo de PDF: texto seleccionable, tabla compleja, escaneo o imagen.
Dos archivos con el mismo nombre pueden tener contenidos distintos. Conservá el original y una identidad técnica —por ejemplo, hash, fecha de descarga y URL— para saber qué versión produjo cada dato.
También conviene clasificar el riesgo. Una tabla sencilla con texto nativo puede resolverse con extracción estructural. Un escaneo inclinado, una tabla partida entre páginas o una ficha con variantes implícitas merece una ruta de revisión más estricta.
Extraer no es interpretar
Texto seleccionable
En un PDF nacido digitalmente, una herramienta puede recuperar caracteres y posiciones. Eso ya es mejor que teclear, pero el orden de lectura puede no coincidir con el orden visual. En una tabla, una columna puede aparecer antes que el encabezado o mezclarse con la siguiente página.
La extracción mecánica debería guardar, como evidencia:
- texto original;
- página;
- coordenadas o caja delimitadora cuando estén disponibles;
- orden de lectura y método utilizado;
- fragmento de tabla o línea asociada;
- identificador del documento y versión.
Tablas complejas
Una tabla no es solo una lista de filas. Puede contener celdas combinadas, encabezados repetidos, unidades en el título, notas al pie, columnas que continúan en otra página y valores válidos solo para ciertas variantes.
Un extractor puede devolver una cuadrícula aparentemente ordenada y perder justo la relación que importa: que “230 V” pertenece a una familia, que “12,50” usa coma decimal o que una tolerancia aplica a todas las filas siguientes.
La salida de una herramienta de tablas es una hipótesis estructural que hay que comparar con la página renderizada. No publiques una fila porque el parser la haya producido sin errores.
OCR y documentos escaneados
Cuando el PDF contiene imágenes, el OCR puede convertir píxeles en caracteres. Es útil para localizar candidatos, pero no convierte la imagen en verdad estructurada. Puede confundir 0 con O, perder signos negativos, alterar comas decimales, unir dos columnas o inventar una separación de palabras.
La PDF Association explica que el contenido PDF puede combinar texto, imágenes y estructuras diferentes; su material sobre OCR y PDF/A también sirve para entender por qué el OCR debe tratarse como una capa de reconocimiento que requiere control, no como una fuente normativa.
En la práctica, el OCR debería producir evidencia con confianza y ubicación. Un valor como 1.500 W no es equivalente si el original dice 1500 W, 1,500 W o 15,00 W. En precios, potencias, dimensiones y códigos de producto, una baja confianza debe bloquear la publicación automática.
El dato necesita modelo y contexto
Supongamos una ficha de una luminaria y una tarifa asociada. El texto extraído encuentra “Luna”, “500”, “40 W”, “4.500 lm” y “125,00 €”. Todavía no sabemos si 500 es diámetro, si los lúmenes son iniciales o mantenidos, si el precio incluye accesorios ni si todos los valores corresponden a la misma variante.
Un registro intermedio razonable podría tener esta forma:
{
  "product_id": "LUNA-500-40-4000",
  "attribute": "luminous_flux",
  "value_original": "4.500 lm",
  "value_normalized": 4500,
  "unit": "lm",
  "condition": "variant Ø500, 40 W, 4000 K",
  "source": {
    "document": "ficha-luna.pdf",
    "version": "rev-06",
    "page": 2,
    "coordinates": [412, 188, 738, 224]
  },
  "confidence": 0.98,
  "review_status": "pending"
}
El ejemplo no pretende definir un esquema universal. Muestra qué se pierde cuando solo guardamos 4500. El valor original permite auditar; el normalizado permite comparar; la condición limita el alcance; la fuente permite volver al documento; el estado evita confundir extracción con aprobación.
Ausente no significa cero
Un modelo debe distinguir al menos:
0: el documento declara cero;not_declared: el documento revisado no lo declara;not_applicable: el campo no aplica a esa variante;unknown: todavía no se pudo determinar;estimated: valor calculado o estimado, nunca equivalente a medido;conflict: dos fuentes vigentes no coinciden.
Convertir un campo ausente en 0 contamina filtros, comparaciones y presupuestos. Y rellenarlo con un valor típico del fabricante introduce una inferencia que el PDF no autoriza.
Normalizar sin borrar el original
Normalizar puede significar traducir un nombre de atributo, convertir una unidad o fijar un formato decimal. No significa reescribir la fuente para que encaje.
Una regla segura conserva ambas capas:
| Evidencia | Dato utilizable |
|---|---|
1,50 m | 1.5 + unidad m |
1500 mm | 1.5 + unidad m |
L90 B10, 50.000 h | mantenimiento con métrica y condición, no solo 50000 |
desde 125 € | precio mínimo con modificador desde, no 125 € cerrado |
220–240 V | rango de tensión, no valor único 230 V |
El sistema debe guardar la transformación aplicada y sus supuestos. Si una unidad es ambigua, se conserva el original y se marca para revisión. Si una tabla mezcla precio de lista, descuento y precio neto, no se normaliza a un único precio sin identificar cuál de ellos declara la fuente.
Las variantes requieren especial cuidado. Un código, una potencia, una dimensión o una temperatura de color pueden cambiar el resto de la fila. No copies un valor de la fila superior para completar una celda vacía: primero verificá si el encabezado o la nota indica herencia, y si no, tratala como no declarada.
Cómo convertir la evidencia en BC3 sin saltos mágicos
El flujo puede organizarse en cinco etapas.
1. PDF → evidencia estructurada
Extraé texto, tablas o imágenes y asociá cada fragmento con página, coordenadas, documento y método. Todavía no estás creando un concepto BC3: estás construyendo un conjunto de evidencias revisables.
2. Evidencia → registro técnico
Asigná identidad, atributo, valor, unidad, condición y estado. En esta fase se resuelven nombres y variantes, pero las ambigüedades deben quedar visibles. El registro puede referir a un producto, un material, una mano de obra, una medición o un precio.
3. Revisión humana
Una persona con conocimiento de producto o de presupuestos confirma:
- que el valor está en la página indicada;
- que el código y la variante coinciden;
- que la unidad y el separador decimal son correctos;
- que la nota al pie no cambia el alcance;
- que el valor no se infirió de una ausencia;
- que el dato puede utilizarse en el destino previsto.
La revisión no consiste en volver a escribir todo. Consiste en concentrar la atención en las excepciones: baja confianza, conflictos, valores críticos y relaciones que el extractor no puede demostrar.
4. Registro técnico → BC3
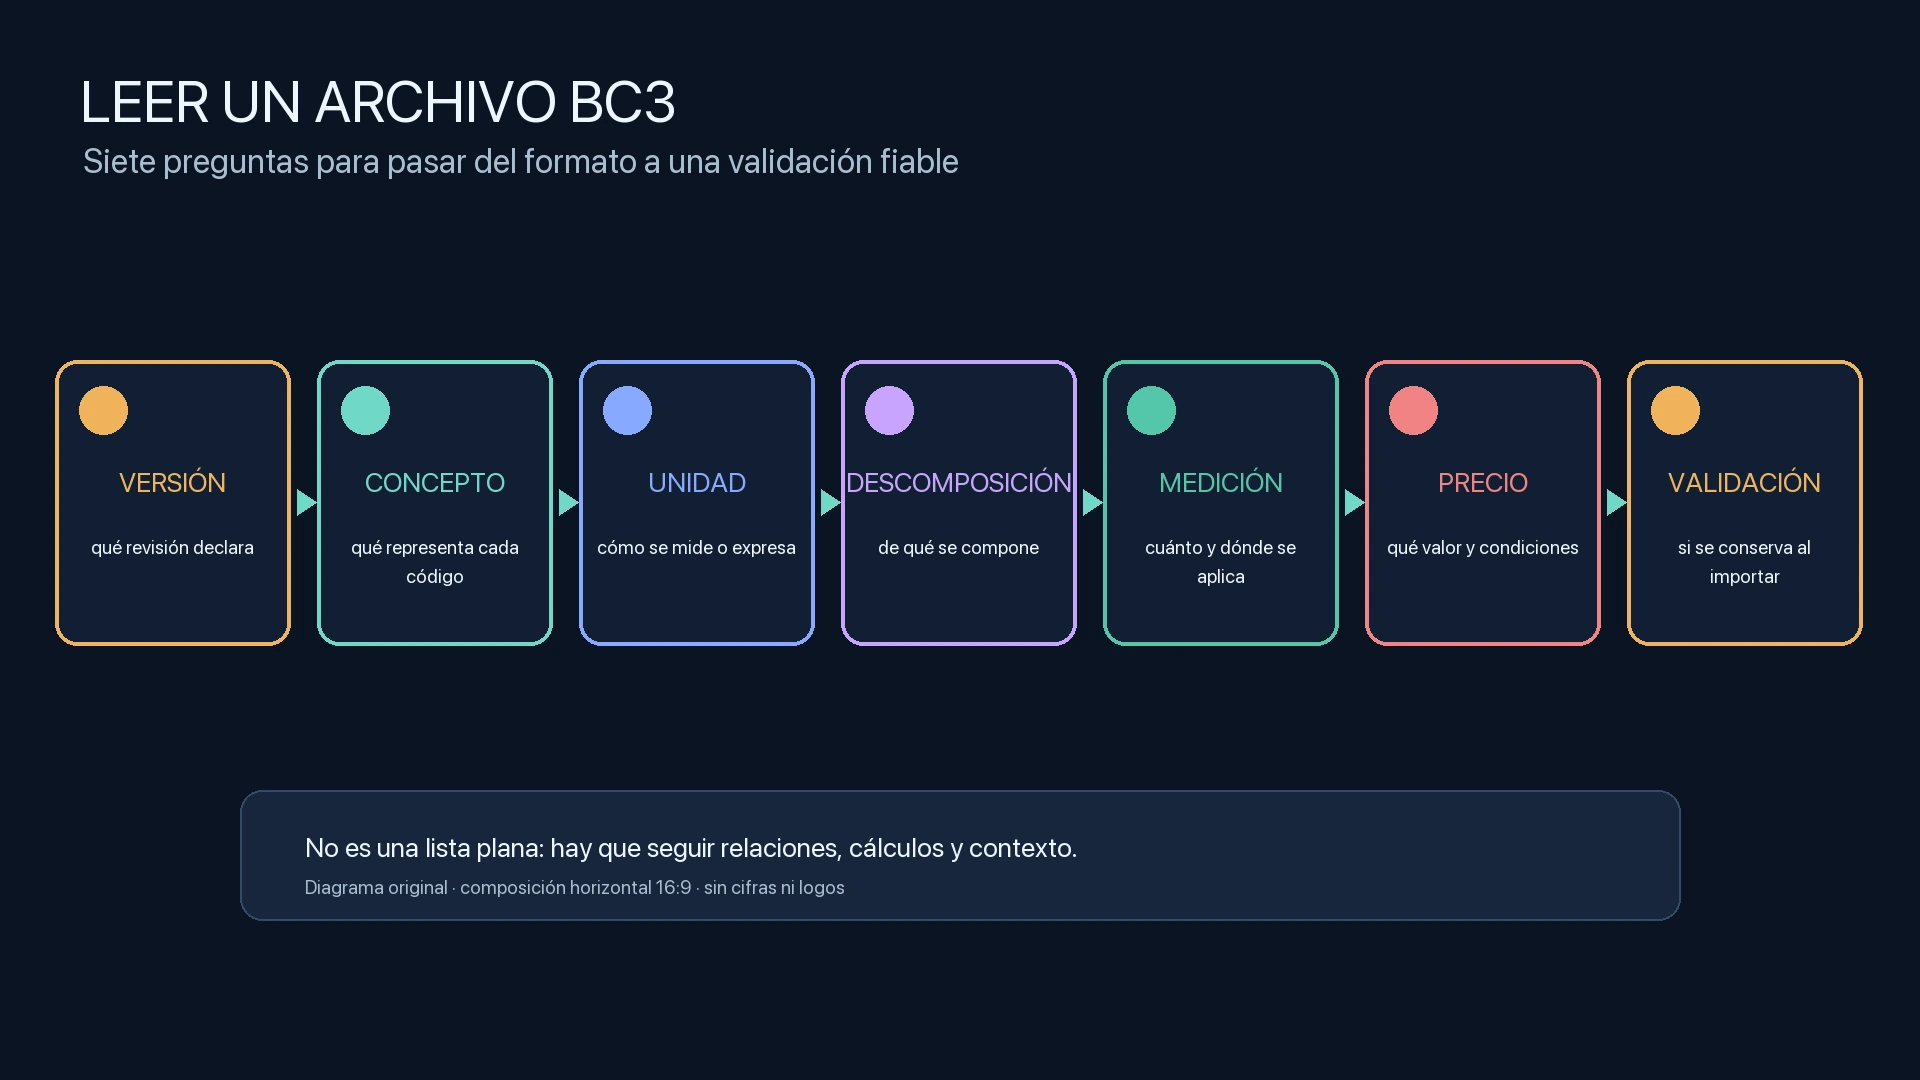
FIEBDC-3/2024 trabaja con registros de conceptos, descomposiciones, mediciones, precios y otros elementos del intercambio. En términos de negocio:
- un concepto identifica una unidad de obra, material, equipo o partida con código, descripción, unidad y precio cuando corresponda;
- una descomposición relaciona un concepto compuesto con sus componentes y cantidades;
- una medición expresa cantidades aplicadas a líneas, capítulos o partidas, con sus datos geométricos o desgloses cuando el presupuesto los usa;
- un precio necesita distinguir su tipo, unidad, condición temporal y fuente para no confundir tarifa, coste o importe calculado.
La especificación define la sintaxis exacta, los separadores, tipos de registro y precisiones. No conviene fabricar un BC3 concatenando cadenas a partir de una tabla extraída: el exportador debe implementar el estándar FIEBDC-3/2024 y generar los registros según el modelo que se haya aprobado.
Un mapeo conceptual podría verse así:
| Evidencia revisada | Representación BC3 posible | Decisión que falta confirmar |
|---|---|---|
Código MAT-001, unidad ud, precio 125 € | Concepto de material | Si el precio es vigente, neto o de lista |
2 ud de MAT-001 dentro de una partida | Descomposición | Si la cantidad es por unidad de obra o total |
Largo 3,20 m, ancho 1,50 m, cantidad 4 | Medición desglosada | Regla de cálculo y redondeo |
| Coste de materiales + mano de obra | Precio/importe del concepto compuesto | Qué precios y fecha intervienen |
La tabla es un puente de diseño, no un fragmento BC3 listo para importar. El estándar es la autoridad para la serialización final.
5. Validación y reimportación
Después de exportar, ejecutá el comprobador oficial o una herramienta compatible con la edición declarada. La validación sintáctica detecta problemas del archivo; no demuestra que la extracción original haya entendido la página.
Por eso hay dos validaciones:
- estructural: el BC3 cumple la sintaxis y puede abrirse;
- semántica: conceptos, unidades, descomposiciones, mediciones y precios conservan el significado revisado.
Reimportá el BC3 en un entorno controlado y compará una muestra con el registro intermedio y el PDF. Verificá cantidades, decimales, códigos, relaciones de descomposición, redondeos y precios. Un archivo que pasa el checker puede seguir teniendo un precio asignado a la variante equivocada.
Qué puede automatizarse y qué no conviene delegar
| Paso | Automatización razonable | Revisión necesaria |
|---|---|---|
| Inventario | detectar archivos, hash, páginas y metadatos | confirmar documento vigente y permisos |
| Extracción | texto, posiciones, tablas y OCR | revisar orden, columnas y caracteres críticos |
| Normalización | unidades y nombres con reglas explícitas | resolver ambigüedad y alcance |
| Identidad | sugerir coincidencias de códigos | aprobar variante y sustituciones |
| BC3 | serializar registros ya aprobados | revisar mapeo y edición del estándar |
| Validación | checker, esquema, rangos y reconciliación | evaluar significado y excepciones |
| Actualización | detectar hash o páginas cambiadas | decidir qué datos revalidar y publicar |
Una confianza numérica no reemplaza a una persona. Puede priorizar la cola de revisión, pero un 0,99 del OCR no demuestra que la cifra corresponda a la variante correcta.
Un piloto acotado para empezar
No hace falta construir una plataforma para saber si el proceso es viable. Elegí un conjunto pequeño y heterogéneo:
- tres o cinco PDFs representativos: texto nativo, tabla compleja y escaneo;
- tres campos de alto valor, por ejemplo código, unidad y precio;
- un modelo de evidencia con página, coordenadas, versión y confianza;
- una persona responsable de aprobar excepciones;
- una salida BC3 limitada a conceptos y precios revisados;
- checker y reimportación sobre una muestra conocida;
- medición de errores, tiempo de revisión y causas de rechazo.
Si el equipo no puede explicar por qué un valor llegó al BC3, todavía no está listo para ampliar el volumen. El siguiente paso no es agregar inteligencia: es corregir la regla, mejorar la evidencia o declarar el campo como pendiente.
El dato reutilizable también necesita mantenimiento
La fecha de extracción no es la fecha de validez. Un fabricante puede cambiar una tarifa, retirar una variante o publicar una revisión con el mismo nombre de archivo.
Mantené una relación entre dato y documento: versión, hash, fecha, página, posición, método de extracción y revisión humana. Cuando cambia el PDF, recalculá qué páginas y campos están afectados. No reemplaces toda la base sin distinguir datos confirmados, pendientes y obsoletos.
También definí responsabilidades: quién mantiene la fuente, quién aprueba el dato técnico, quién valida el BC3 y quién responde por su uso en un presupuesto o una propuesta. La trazabilidad no es un adorno de auditoría; es lo que permite corregir sin perder confianza.
Convertir documentos en decisiones
Extraer texto es relativamente fácil. Construir un dato que se pueda comparar, presupuestar, publicar y volver a auditar es el trabajo importante.
Un PDF técnico no declara lo que no declara. El OCR no entiende automáticamente las variantes. Una tabla no conserva siempre sus relaciones al copiarla. Y un BC3 válido no demuestra que el dato de origen haya sido interpretado correctamente.
El recorrido robusto es más humilde y más útil: conservar la evidencia, modelar el contexto, revisar las excepciones, exportar con el estándar correspondiente y validar mediante reimportación. Recién entonces el dato deja de ser texto recuperado y empieza a ser información técnica confiable.
Fuentes consultadas
- FIEBDC, Formato FIEBDC-3/2024, especificación oficial de sintaxis, registros, conceptos, descomposiciones, mediciones, precios y compatibilidad: PDF oficial, vigente desde el 1 de enero de 2024.
- FIEBDC, BC3 format and official checker, versiones en vigor y comprobador oficial: fiebdc.es/format-fiebdc, consultado el 29 de agosto de 2026.
- FIEBDC, Programas y versiones, información publicada sobre soporte de FIEBDC-3/2024 en programas compatibles: fiebdc.es/programas-y-versiones, consultado el 29 de agosto de 2026.
- PDF Association, FAQ: AI and PDF, diferencias entre contenido PDF, texto, imágenes y estructuras documentales: pdfa.org/faq-ai-and-pdf, consultado el 29 de agosto de 2026.
- PDF Association, OCR and PDF/A: The Foundation Your Enterprise AI Is Missing, papel del OCR, PDF/A y la calidad del contenido documental: pdfa.org/ocr-and-pdfa-the-foundation-your-enterprise-ai-is-missing, consultado el 29 de agosto de 2026.
Lecturas relacionadas
También te puede interesar
Para explorar